AI简历筛选准确率,是指AI系统对候选人简历与岗位匹配度的判断结果,与资深HR人工判断之间的一致性比例。决定这个数字高低的,不是单一的算法模型,而是数据质量、语义理解深度、岗位画像精度和持续学习机制四个变量的交叉作用。
2026年,AI简历筛选已从锦上添花变成招聘效率的核心分水岭——据国际人力资源分析协会(AIHR)《2026年HR优先事项报告》,能否善用AI推动团队持续成长,已成为衡量HR核心竞争力的重要标准。
Moka AI在头部新能源车企的实测中,智能简历筛选与HR推荐一致率达87%,系统月均处理简历超86,000份,验证了准确率背后的技术逻辑。
💡 想了解更多 AI简历筛选准确率是什么决定的?2026年一篇讲透 的实践经验?Moka AI 为 HR 团队提供智能化解决方案
准确率的本质:不是对错,而是一致性
AI简历筛选准确率衡量的是AI判断与人类专家判断的吻合程度,而不是一个绝对的对或错。 理解这一点,是所有选型讨论的前提。
准确率 ≠ 关键词匹配命中率
很多人把准确率等同于简历里有没有出现岗位要求的关键词。实际上,关键词命中只是最浅层的信号。一个候选人写了Python不代表能用Python做数据分析,一个没写项目管理的人可能有丰富的跨部门协调经验。2026年主流的AI筛选系统评估的是语义层面的能力匹配——候选人的经历描述是否体现了岗位所需的核心能力,而非文字表面的重合度。
准确率 ≠ 通过率
另一个常见混淆:把准确率和通过率划等号。准确率高不意味着通过的人多,而是意味着AI推荐的候选人中,资深HR也认为值得推进的比例高。一个准确率90%但通过率只有15%的系统,远比准确率60%但通过率40%的系统更有价值——前者帮HR精准锁定了最匹配的人,后者则让HR在一堆凑合能看的简历里继续人工二筛。
核心判断标准:看AI筛选结果与资深HR判断的一致率,而不是看支持AI筛选的功能列表。
拆解准确率:四个核心变量逐层解析
AI简历筛选准确率由四个变量共同决定:①数据质量 ②语义理解深度 ③岗位画像精度 ④持续学习机制。任何一个环节薄弱,整体准确率就会被拉低。
1. 数据质量:垃圾进,垃圾出
简历数据的结构化程度直接决定AI的判断基础。同一份PDF简历,解析引擎能否准确提取教育背景、工作年限、项目经历、技能标签,差异巨大。解析错误会向下传导——把3年Java开发解析成3年+Java两个独立字段,AI就无法判断这是一个有3年Java经验的人。Moka AI的简历解析引擎累计处理超1,000万份简历,覆盖中英双语、多种文件格式,解析准确率处于行业领先水平,这是筛选准确率的第一道关卡。
2. 语义理解深度:读懂言外之意
关键词匹配是布尔逻辑,语义理解是认知能力。负责从0到1搭建用户增长体系和参与用户运营日常工作,岗位关键词可能都含用户运营,但前者的含金量远高于后者。2026年的AI筛选模型需要具备表述深度反推能力——从候选人的用词、叙事结构、成果量化程度,推断其真实能力层级。
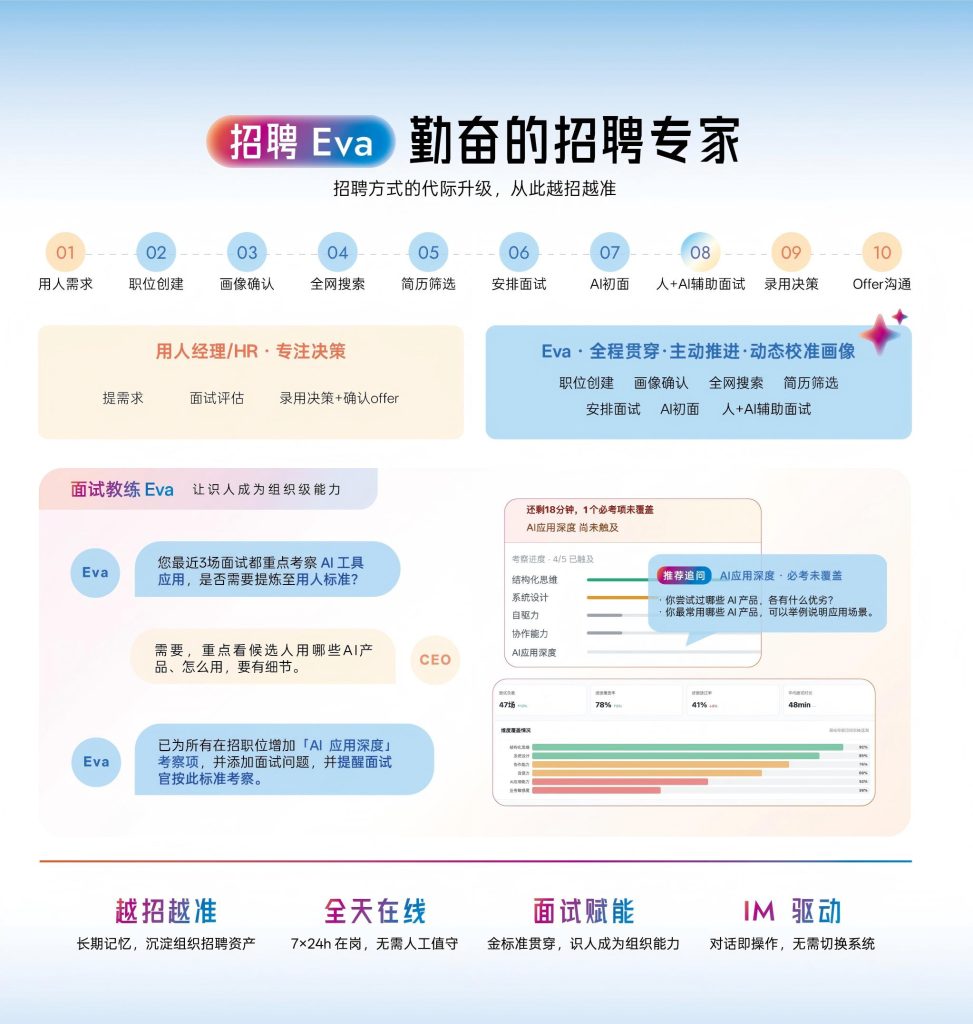
招聘Eva已上线AI能力分层识别功能,可区分候选人是浅层认知、有动手经验还是深度实操者三个层级,这在AI技能岗位招聘中尤为关键。
3. 岗位画像精度:标准越清晰,判断越准
AI筛选的准确率上限,取决于标准本身是否清晰。如果岗位画像只写本科以上、3年经验、沟通能力强,AI能做的判断空间极为有限。反之,当岗位画像包含具体的能力权重、行业偏好、项目类型偏好时,AI才能做出精细化的匹配排序。这也是为什么同一套系统在不同企业、不同岗位上的准确率差异可达15-20个百分点——不是算法不行,是输入的标准不够精确。
4. 持续学习机制:用得越多越准
静态模型的准确率会随时间衰减。岗位需求在变,候选人的表述习惯在变,行业术语在迭代。一个没有学习机制的AI筛选系统,上线半年后准确率可能下降10-15%。真正有效的系统需要一个反馈-学习的闭环:HR对筛选结果的每一次通过或拒绝操作,都应回传给模型作为训练信号。
招聘Eva的设计理念正是如此——有记忆、越来越懂你,每次筛选反馈都会沉淀为企业专属的用人偏好数据。
三个认知误区:很多人在这里判断失误
误区一:准确率越高的系统一定越好
很多人以为准确率是唯一指标,实际上召回率同样关键。 一个准确率98%但只推荐3个人的系统,可能漏掉了20个合适的候选人。选型时要同时关注推了多少人是对的(准确率)和合适的人有多少被推出来了(召回率)。两个指标的平衡点,才是系统真实水平的体现。
误区二:AI筛选可以完全取代人工判断
AI筛选解决的是效率问题,不是决策问题。据Moka官方数据,在头部新能源车企的实测中,5,000+份简历的销售岗AI一致率达90%,研发岗一致率86%。这意味着仍有10%-14%的判断差异需要人工复核。AI的价值在于把HR从看500份简历挑50份的体力劳动中解放出来,让HR的精力集中在50份里选10个最终面试的高价值判断上。
误区三:所有岗位的筛选准确率应该差不多
岗位标准化程度越高,AI筛选准确率越高。技术岗(明确的技能栈、项目经验要求)的准确率通常比管理岗(软性能力、领导力)高出10-20个百分点。选型时不能拿通用的准确率数字做决策,而要关注系统在自己行业、自己岗位类型上的实测表现。
💡 想提升 AI简历筛选准确率是什么决定的?2026年一篇讲透 效率? Moka AI 的三位 Eva 同事(招聘 Eva、人事 Eva、BP Eva)可以帮助 HR 团队自动化 80% 的重复性工作。 ✨ 智能简历筛选 | 📊 自动数据分析 | 🤖 24/7 候选人服务
反直觉洞察:决定准确率的最大变量,往往不是AI模型本身,而是企业能否给AI提供足够清晰的岗位标准和足够多的反馈数据。
Moka AI 如何把准确率从概念变成可交付的结果
准确率不是一个静态参数,而是一套持续优化的系统工程。Moka AI围绕上述四个变量,构建了完整的落地能力:
解析层:高精度简历结构化
Moka AI的简历解析引擎基于深度模型,累计处理超1,000万份简历,支持PDF、Word、图片等多格式解析。结构化提取字段覆盖教育背景、技能标签、项目经历、职级轨迹等维度,为后续语义匹配提供干净的数据输入。
筛选层:语义匹配+AI味甄别
基于岗位画像自动评分排序,筛选一致率在头部新能源车企实测中超86%(HR推荐一致率达87%)。2026年新上线的AI味甄别能力,可识别简历是否存在AI代写、过度润色痕迹,帮助HR规避简历注水风险——这是当前AI普及背景下准确率面临的新挑战。
学习层:数据飞轮驱动持续优化
招聘Eva具备长期记忆能力,记住每次筛选、面试的反馈。企业用得越久,系统对该企业用人偏好的理解越深。某能源行业头部企业接入后,月均完成4,000+次AI初筛,面试反馈率提升50%——反馈数据反哺模型,形成使用→反馈→优化→更准的正向循环。
标准层:面试教练Eva反向校准筛选标准
Moka AI在2026年推出的面试教练Eva,从企业真实面试历史中自动提炼用人金标准,将录用与入职后的表现数据反馈回筛选模型。这意味着筛选标准不再只是HR的主观输入,而是被入职后的真实数据持续校准。据官方数据,面试官在面试教练Eva辅助下,评分从第1场的72分提升到第4场的85分,标准的一致性和准确性同步提升。
| 准确率核心变量 | Moka AI 对应能力 | 关键数据 |
| 数据质量 | 深度简历解析引擎 | 累计处理1,000万+份简历 |
| 语义理解 | 能力分层识别 + AI味甄别 | 筛选一致率86%-90% |
| 岗位画像 | 动态人才画像 + 用人金标准 | 面试官评分4场提升13分 |
| 持续学习 | 长期记忆 + 数据飞轮 | 月均4,000+次初筛反馈闭环 |
Moka AI凭借AI Agent在招聘全场景的深度落地,于2026年斩获非凡奖最佳人力资源Agent平台,服务3,500+家企业,客户续约率达96%。
常见问题解答(FAQ)
AI简历筛选准确率一般能达到多少?
准确率因岗位类型和企业使用深度而异。标准化程度高的技术岗,主流系统的准确率通常在80%-90%区间;软性能力要求多的管理岗则在70%-80%。Moka AI在头部客户的实测中,销售岗一致率达90%,研发岗达86%-87%。关键变量不只是模型,更在于企业是否提供了清晰的岗位画像和持续的筛选反馈。
AI筛选会不会漏掉优秀但非典型的候选人?
这是召回率问题。纯关键词匹配的系统确实容易漏人,但语义理解型AI会分析候选人经历的实质内涵而非字面表述。建议选型时关注系统是否支持宽筛窄选模式——先用较宽的标准召回候选池,再用精细维度排序推荐,避免因标准过严导致优质人才流失。
如何判断一套AI筛选系统的准确率是否可信?
要求厂商提供同行业、同岗位类型的实测数据,而非通用的平均数字。重点看三个指标:一致率(与HR判断的吻合度)、召回率(合适候选人的覆盖比例)、样本量(测试基于多少份简历)。样本量低于500份的准确率数据参考价值有限。
想看看AI简历筛选在你的岗位上能做到多准?
Moka AI 的招聘Eva已为3,500+家中大型企业提供AI原生的智能筛选方案,从简历解析到语义匹配再到持续学习,准确率可验证、可追踪。立即免费试用,用你自己的岗位数据验证效果。