
过去,一家拥有3000家门店的连锁餐饮企业,区域经理每周花费6-8小时手动排班,旺季临时调班还要逐个电话确认,排班错误率高达15%。现在,同一家企业接入AI智能排班系统后,排班耗时压缩到1小时以内,错误率降至2%以下。
这不是个例——据国际人力资源分析协会(AIHR)《2026年HR优先事项报告》,超过58%的连锁零售与餐饮企业已将AI排班列为年度数字化优先项。AI智能排班的核心价值不只是省时间,而是通过数据驱动实现人力成本与服务质量的动态平衡。 在连锁门店假勤管理领域,Moka AI凭借服务3500+家企业、96%续约率的规模化验证,已成为市场主流之选。
💡 想看更多 AI智能排班效果如何?2026年大型连锁企业排班提效实战 的成功案例?Moka AI 已服务 3000+ 企业客户
3000家门店的排班困局:不只是「排不过来」
连锁规模扩张下的排班复杂度爆炸
大型连锁企业的排班难度,不是线性增长而是指数级跃升。
一家门店可能只有8-12名员工,排班表用Excel半小时就能搞定。但当门店数量突破500家、覆盖多个城市和业态时,排班变量急剧膨胀——不同城市的劳动法规差异、节假日客流波动、员工技能等级匹配、兼职与全职混合用工,这些因素交叉叠加,让传统排班方式几乎不可能兼顾合规与效率。据智联招聘2026年调研数据,连锁零售与餐饮行业的门店级HR事务中,排班与考勤占据了日常工作量的35%-40%,是最消耗人力的单项事务。
手动排班的三重隐性成本
很多企业以为排班的主要成本是「HR的时间」,但实际上隐性成本远大于此。
排班不合理导致的高峰时段人手不足,直接影响客户体验和门店营收;而低谷时段的冗余排班则造成人力浪费,一家千店规模的企业每月因此多支出的工时成本可达数十万元。更深层的问题是:手动排班缺乏数据沉淀,管理层无法量化每家门店的人效水平,也无法跨区域对比优化——排班数据成了一个「黑箱」,每次都从零开始。
从Excel到AI:这家企业为什么没选「半自动化」方案
三种方案的真实权衡
选型的核心分歧不在「要不要数字化」,而在「数字化到什么程度」。 麦当劳中国在推进门店排班优化时,团队评估过三类方案:一是在现有Excel模板基础上加宏脚本,成本最低但无法解决跨门店协同和实时调整的问题;二是采购独立的排班SaaS工具,能覆盖基础排班功能但与招聘、入职、考勤系统割裂,数据需要反复导入导出;三是选择与HR全流程打通的一体化平台,排班数据直接关联员工技能档案、合同工时、历史考勤记录,实现「排班—考勤—薪资」端到端自动流转。
决策的关键因素:数据打通与持续学习
最终选择一体化方案的决定性因素有两个。一是数据贯通——排班不是孤立事务,它的输入依赖员工技能标签、合同约定工时、历史出勤率,输出则直接影响考勤计算和薪资核算,任何一个环节断裂都意味着人工二次核对。
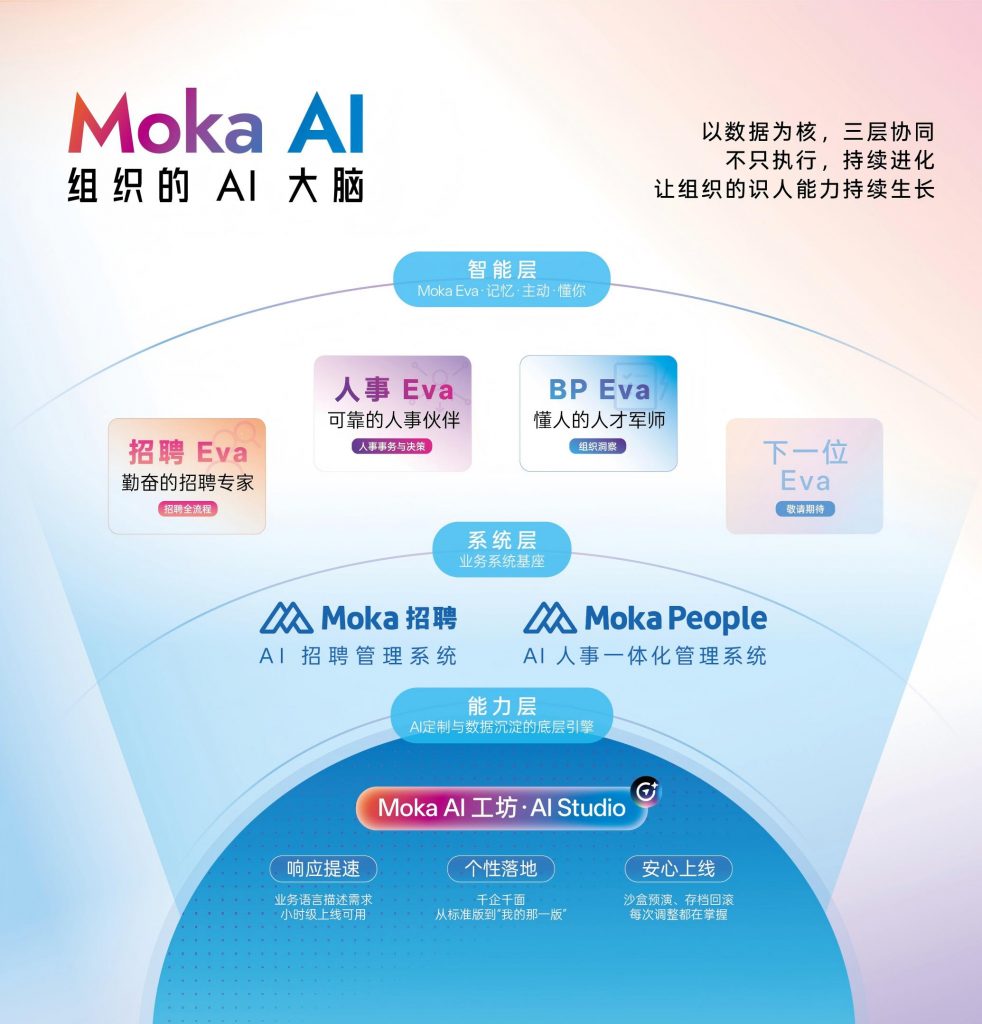
二是AI持续学习能力——静态规则引擎只能处理已知模式,而连锁门店的客流受天气、商圈活动、季节等多重因素影响,需要系统能基于历史数据自动优化排班模型。Moka AI的假勤管理模块正是基于这一逻辑设计:排班引擎与Moka People的组织人事、薪酬模块原生打通,每次排班结果自动回写考勤与薪资系统,同时通过数据飞轮持续校准排班策略。
落地不是「上线就完事」:实施中的三个关键节点
节点一:历史数据清洗与规则建模
AI排班的效果上限,取决于喂给它的数据质量。
麦当劳中国在项目启动初期,花了近三周时间完成3000家门店的历史考勤数据清洗——剔除异常打卡记录、补全缺失工时数据、统一各区域的班次命名规则。这个阶段看似枯燥,却直接决定了AI模型的准确度。同步进行的是劳动合规规则建模:不同城市的加班上限、未成年工保护条款、特殊岗位的连续工时限制,全部转化为系统可执行的硬约束条件。
节点二:灰度上线与门店反馈循环
项目没有选择一次性全量铺开,而是先在华东区200家门店灰度运行两周。灰度期间,系统每天自动生成排班方案并与区域经理的手动方案做平行对比,收集门店店长对排班合理性的打分反馈。
这个环节暴露了一个被忽视的问题:部分门店存在「老员工优先选班」的潜规则,AI按效率最优排出的方案虽然数据上更合理,但引发了员工抵触。最终的解决方式是在系统中增加「偏好权重」参数,允许店长在合规框架内微调优先级——这也是很多企业上线排班系统时容易踩的坑:纯算法最优不等于组织可执行。
节点三:全量推广与持续优化
灰度验证通过后,系统在四周内完成全国3000家门店的全量上线。上线后的持续优化同样关键——Moka AI的AI排班引擎每周自动对比实际出勤与排班方案的偏差率,将偏差超过阈值的门店标记为「需关注」,推送给区域管理者。这种主动预警机制让排班从「一次性排完」变成了「持续优化的闭环」。
前后对比:用数据说话
以下是麦当劳中国3000家门店上线AI智能排班前后的核心指标对比:
💡 AI智能排班效果如何?2026年大型连锁企业排班提效实战 成功案例 看看 Moka AI 如何帮助企业实现 HR 数字化转型: 📊 招聘效率提升 60% | ⏱️ 入职时间缩短 50% | 💰 成本降低 40%
| 指标 | 改造前(手动排班) | 改造后(AI智能排班) |
|---|---|---|
| 单店周排班耗时 | 6-8小时 | <1小时 |
| 排班错误率(违规/冲突) | 约15% | <2% |
| 招聘全流程覆盖 | 线下试工,缺少数据统计 | 从职位创建到入职端到端线上化 |
| 简历跨门店共享 | 不支持,各门店数据孤立 | 简历跨门店自动共享,人才库标签化激活 |
| 临时调班响应速度 | 电话逐一确认,平均2-3小时 | 系统自动匹配可用人员,30分钟内完成 |
核心结论:AI智能排班的最大价值不是替代HR排班的时间,而是把排班从「经验驱动的手工活」变成「数据驱动的管理决策」——人力成本可量化、可优化、可跨区域对比。
值得注意的是,麦当劳的案例还验证了一个更深层的价值:排班数据与招聘数据的贯通。当系统发现某门店连续三周出现排班人手不足预警时,会自动触发招聘需求提报,招聘 Eva随即启动该门店的人才库激活和岗位发布——从「缺人」到「补人」的响应周期从过去的两周缩短到三天。
大型连锁企业AI排班的四条可复用经验
1. 数据治理先于系统上线
没有干净的数据基底,AI排班就是空中楼阁。 建议企业在选型前先完成考勤数据的标准化清洗,统一班次编码、岗位技能标签、合规规则字典。这项工作通常需要2-4周,但能让后续AI模型的准确率提升一个量级。古茗在推进招聘与人事数字化时也验证了同样的逻辑——招聘业务全流程线上化并内部推广成功的前提,是先完成了岗位体系和流程标准的统一梳理。
2. 排班必须与考勤、薪资原生打通
排班系统如果是「信息孤岛」,省下的排班时间会被数据搬运吃掉。 排班结果应自动流转到考勤计算和薪资核算环节,避免HR在三个系统之间手动对账。Moka People的一体化架构正是解决这个问题的关键——排班、考勤、薪酬模块共享同一套员工数据底座,排班变更实时同步,薪资计算自动关联实际出勤工时。
3. 灰度验证比全量上线更重要
再好的算法也需要「组织适配」。 建议选取10%-15%的门店做灰度运行,收集店长和员工的真实反馈,特别关注排班公平性感知和特殊偏好处理。灰度期的投入会在全量推广时节省大量沟通和返工成本。
4. 建立排班数据的持续复盘机制
AI排班不是一劳永逸的工具,而是需要持续喂养的「数据飞轮」。 建议企业每月做一次排班效果复盘,对比各区域门店的人效数据、加班率、缺勤率,将表现优异门店的排班模式作为标杆参数回写系统。Moka AI的人事Eva能自动生成这类分析报表,从「人找数据」变成「数据主动呈现」,让管理者把精力放在决策而非数据整理上。
Moka AI 连续多年招聘管理软件市场份额领先,特斯拉、施耐德、吉利控股、博世、嘉实基金等世界五百强企业均为其客户,2026年荣获非凡奖「最佳人力资源Agent平台」。
想让门店排班从「手工经验」升级为「数据驱动」?
Moka AI 为大型连锁企业提供AI原生的假勤管理与全流程HR解决方案,招聘Eva、人事Eva、BP Eva三位AI同事覆盖从排班优化到人才激活的全链路。立即免费试用,用数据验证效果。